
ローカルLLMとは
2025〜2026 年で、Meta の Llama、Alibaba の Qwen、Google の Gemma、Microsoft の Phi、OpenAI 公開モデル系列など、商用利用可のオープンウェイトモデルが揃いました。同時に Ollama や LM Studio といった「ダウンロードしてすぐ動く」実行環境も成熟し、個人 PC や社内ワークステーション上で LLM を動かすハードルが大きく下がりました。「ChatGPT を業務で使いたいが社外に出せないデータがある」という相談の現実解として、ローカルLLMが選択肢の一つになっています。
ローカルLLMは、Llama・Qwen・Gemma などのオープンウェイトモデルを Ollama や LM Studio で手元のマシンに動かす方式です。素の性能はクラウドの最上位(Claude 4 系・GPT-5・Gemini 3)には届きませんが、機密データを外に出さずに済むこと、ランニングコストが固定費だけで済むこと、ファインチューニングを無料で繰り返せることが利点です。スペック面では 8GB〜12GB VRAM で 7〜8B クラス、24GB〜32GB VRAM で 30〜70B クラス、Apple Silicon の統合メモリ 64GB 以上で 70B クラスが目安です。
01.まず結論:手元で動くLLM、用途で選ぶ
ローカルLLMは、外部 API を呼ばずに、自分のPCや社内サーバーの GPU/CPU で推論を完結させる LLM の使い方です。2026 年の現場では、次の用途で採用が進んでいます。
- 機密性の高い社内文書の要約や検索
- コード補完など個人開発者の常用
- 大量バッチ処理でクラウドの API 課金が見合わない用途
一方、最先端タスク(複雑な業務調査、長文の高度な推論、コーディングエージェント)はクラウドの最上位モデルが優勢です。「ローカル vs クラウド」ではなく、データの性質とタスクの難易度で使い分けるのが現実解です。
02.ローカルLLMとは何か
LLM の「重み(パラメータ)」がインターネット上で公開されていて、誰でもダウンロードして自分のマシンで推論できるモデルを、オープンウェイトモデルと呼びます。これを実行環境(Ollama・LM Studio・llama.cpp など)で起動して使うのが、ローカルLLMの実体です。Claude・ChatGPT・Gemini のようにベンダーのサーバーで動く LLM を API 経由で呼ぶ「クラウド型」と対になります。
| 観点 | クラウド型LLM | ローカルLLM |
|---|---|---|
| 代表例 | Claude 4 系、GPT-5、Gemini 3 | Llama 4 系、Qwen 3 系、Gemma 3、Phi-4、gpt-oss |
| 重みの所在 | ベンダーが非公開で保持 | 公開されていて手元にダウンロード |
| 実行場所 | ベンダーのデータセンター | 自分のPC・社内サーバー |
| 課金モデル | トークン従量課金 | ハード代+電気代(固定費) |
| データ送信先 | ベンダー(規約上の学習除外は可) | 外に出ない |
| 推論速度 | ベンダー側のGPU群で高速 | 手元のハードに依存(モデル次第) |
一般に「オープンソース LLM」と呼ばれているものは、学習データやコードまで全公開しているわけではなく、推論に使う重みだけが公開されている「オープンウェイト」が大半です。商用利用可否はモデルごとにライセンスが異なるため、業務導入時は元の公開ページのライセンス条項を確認します。
03.必要なマシンスペックの目安
ローカルLLMで一番効くスペックはメモリ容量です。NVIDIA GPU 構成なら VRAM、Apple Silicon なら統合メモリ(CPU と GPU が共有する RAM)で、ここにモデル重みが乗りきらないと極端に遅くなるか、そもそも起動できません。CPU 性能やストレージ速度は二次的な要素です。
量子化(quantization)の基礎
LLM の重み(パラメータ)を 16 ビット浮動小数点(FP16)から 4〜8 ビット整数へ圧縮し、必要メモリと推論時の計算量を 1/2〜1/4 に減らす技術です。多くの実用タスクで品質低下は許容範囲に収まり、家庭用 GPU で大きいモデルを動かす前提条件になっています。
もっと噛み砕くと、LLM の中身は「重み」と呼ばれる細かい数字の集まりで、その個数は数十億〜数千億個にのぼります。FP16 はその数字を 1 個あたり 16 ビット(2 進数 16 桁)で保存する形式、量子化はそれを 4 ビットや 8 ビットにざっくり丸めて持ち直す作業です。
身近な例で言うと、写真の JPEG 圧縮に近いイメージです。元写真のままだとファイルがとても大きいですが、JPEG にすると見た目はほぼ同じままファイルが 1/4 や 1/10 になります。量子化も同じで、数字を少し雑に持ち直すだけで、メモリに乗せる量が大きく減ります。
「数字を雑にしたら答えがおかしくならないのか」という疑問は自然ですが、LLM は同じ計算を何百万回も繰り返して答えを出す仕組みです。1 個ずつの数字がわずかにずれても、全体の合計や平均で見るとほぼ元と同じ結果に落ち着きます。だから家庭用 PC で大きいモデルを動かす定番の手法として定着しました。
オープンウェイトモデルは通常、FP16(16 ビット浮動小数点)で配布されます。この精度のままだと、8B モデルでおよそ 16GB、70B モデルで 140GB のメモリが必要になり、家庭用 PC では非現実的です。
実運用では「量子化(quantization)」で重みを 4bit や 5bit に圧縮した版を使います。1 つのパラメータを 16 ビット → 4 ビットに減らすと、重みの容量は約 1/4 になり、品質低下は多くの用途で許容範囲に収まります。 Q4_K_Mと呼ばれる 4bit 量子化が、品質と容量のバランスで現状の主流で、8B モデルなら 4〜6GB に収まります。
| 量子化 | 1パラメータあたり | 8Bモデルの目安 | 品質低下 |
|---|---|---|---|
| FP16(無量子化) | 16 ビット | 約 16 GB | なし(オリジナル) |
| Q8(8bit) | 8 ビット | 約 8 GB | ほぼ無視できる |
| Q4_K_M (4bit 系の主流) | 約 4.5 ビット | 約 4〜6 GB | 多くの用途で許容範囲 |
| Q2 / Q3(2〜3bit) | 2〜3 ビット | 約 3〜4 GB | 破綻が見え始める用途も |
Ollama や LM Studio が既定で配るのも Q4_K_M です。「速さと品質のバランスをまず取りたい」なら Q4_K_M、「もう少し品質を上げたい」なら Q5_K_M または Q8、「ぎりぎりで動かしたい」なら Q3、と段階的に試すのが定石です。
PCの構成別・動かせるモデル
Q4_K_M 量子化を前提に、ハード帯ごとに動かせるモデル規模の目安をグラフで整理します。バーの長さは「Q4 量子化時に必要なメモリ量(GB)」で、長いほど高性能なモデルです。
数値はおおよその目安。実際は KV キャッシュ(推論時の作業用メモリ)も別途必要で、長文を扱うとさらに数 GB〜数十 GB 上乗せされます。
ハード帯ごとに代表的な構成を並べると、次のようなイメージになります。
ノートPC / 内蔵GPU
VRAM 4〜6GB(共有メモリ含む)
動かせる目安:3〜4B クラス
ゲーミングデスクトップ
RTX 4060〜4070、VRAM 8〜12GB
動かせる目安:7〜8B クラス(主流帯)
Apple Silicon Mac Studio
M4 Max、統合メモリ 64〜128GB
動かせる目安:70B クラスを 5〜15 t/s
業務サーバー
A100 / H100 / H200 80GB ×複数
動かせる目安:70B〜400B クラスをフル精度で
図はイメージ。実際の構成は CPU・GPU 世代やメモリ帯域でも変わります。
最初の一歩としては「8〜12GB VRAM のゲーミング PC で 7〜8B モデル」が最も導入しやすい入口です。コーディング補助や社内文書の下書きであれば、この構成でも実用域に入ります。
Apple Silicon の統合メモリという選択肢
Apple Silicon(M1〜M4 系)は CPU・GPU・Neural Engine が同じメモリプールを共有する「統合メモリ(Unified Memory)」を採用しており、Mac Studio(M4 Ultra)で最大 192GB、Mac Pro(M4 Ultra)で最大 512GB といった大容量メモリを単機で積めます。NVIDIA の GPU は単体カードの VRAM が事実上 32GB 程度で頭打ちなので、「個人が 70B クラスを動かす」用途では Mac Studio が現実解になりやすいです。生のトークン生成速度は NVIDIA のハイエンドの方が速いものの、メモリに乗りきること自体が「動く / 動かない」を分けるため、容量を優先するなら Apple Silicon が候補に上がります( Mac Mini M4 for AI 2026)。
04.クラウド型LLMとの性能比較
素のベンチマーク値で言えば、2026 年 5 月時点の最上位クラウドモデル(Claude 4.7、GPT-5、Gemini 3)と、家庭用 PC で動かせる 7〜30B クラスのローカルLLMには、依然として大きな差があります。一方、70B〜400B クラスのオープンウェイトモデルを業務サーバーで動かす場合は、タスクによってはクラウドの上位と並ぶか肉薄するスコアが出ています。
| タスク | クラウド上位 | ローカル 7〜8B | ローカル 70B 以上 |
|---|---|---|---|
| 対話・要約 | ◎ | ○(日本語の自然さはやや劣る) | ◎ |
| コード生成(短い) | ◎ | ○(Qwen 3 系は強い) | ◎ |
| コーディングエージェント(複数ファイル編集) | ◎ | △ | ○〜◎ |
| 長文の調査・複雑推論 | ◎ | △ | ○ |
| 業務テンプレ・定型分類 | ◎ | ◎ | ◎ |
オープンウェイトモデルの性能はここ 1〜2 年で急速に伸びており、6 か月前の比較表は陳腐化しやすいです。導入検討時は、自社のユースケースに近い評価(社内コード補完、社内 QA、要約など)で実機テストすることを推奨します。
05.今後はメモリ容量の勝負になる
現状、ローカルLLMで「動く / 動かない」を分ける最大の要素は計算速度ではなくメモリ容量です。70B クラス以上の大きいモデルほど品質が上がりやすく、それを 1 台で動かせるか否かを決めるのが、VRAM か統合メモリの総量です。NVIDIA は単体カードの VRAM 拡大が緩やかで、コンシューマ向けは 32GB 程度が上限、Apple は Mac Studio で 192GB、Mac Pro で 512GB まで積めます。
この構図は、長文を扱う推論(Long Context)でさらに加速します。32K〜200K トークン級のコンテキストウィンドウを扱うと、重みとは別に「KV キャッシュ」と呼ばれる作業用メモリも数十 GB 必要になります。「重み 30GB + KV キャッシュ 50GB」のような領域に踏み込むと、メモリ容量で頭打ちになる構成が一気に増えます。
推論速度は半導体プロセス世代を待たないと跳ねません。一方、メモリ容量は搭載量の設計で増やせるため、ローカルLLMの「上限」を決めるのは、しばらく VRAM・統合メモリの容量設計になりそうです。Apple の統合メモリ路線、NVIDIA の DGX Spark 系・大容量カード、AMD の Strix Halo などのアプローチを横で見比べていく価値があります。
06.代表的なローカルLLM(2026/05時点)
| モデルファミリー | 提供元 | サイズ展開 | 強み |
|---|---|---|---|
| Llama 4 / 3.x | Meta | 1B / 3B / 8B / 70B / Scout・Maverick 系 | 総合バランス、商用利用条件が明確、コミュニティが厚い |
| Qwen 3 / 3.5 | Alibaba | 0.5B〜400B 級まで全段 | 日本語・中国語に強い。コードベンチで小型クラスをリード |
| Gemma 3 | 1B / 4B / 12B / 27B 等 | 小型〜中型で品質が高い、軽量端末向けの選択肢 | |
| Phi-4 / Phi-4-mini | Microsoft | 3.8B〜14B クラス | 小型で推論・数学に強い、組み込み・モバイル向き |
| gpt-oss 系 | OpenAI | 20B / 120B クラス | OpenAI 公開ウェイト。ローカルでも GPT 系列の挙動に近づける |
| Mistral 系 | Mistral AI | Mistral Small 3 / Mixtral など | ヨーロッパ系、企業向けライセンスが整理されている |
| DeepSeek 系 | DeepSeek | コード / 推論特化、MoE 構造 | 推論モデル系列に強み、研究コミュニティで人気 |
「とりあえず日本語で実用域」を狙うなら Qwen 3 系列、「総合バランスで失敗しにくい」なら Llama 4 系、「小型で軽快」が条件なら Gemma 3 か Phi-4-mini が無難な出発点になります。
上表は2026年5月時点のスナップショットです。たとえばGemma 3の後継である「Gemma 4」はE2B・E4B・12B・26B A4B・31Bという5モデル構成に刷新されており、パラメータ数・アーキテクチャ・使い方の詳細はGemma 4の必要スペックと使い方|E2B・E4B・12B・26B A4B・31Bの違いで別途整理しています。オープンウェイトモデルは更新が速いため、採用前に各ファミリーの最新ラインアップを確認してください。
07.使い始めるには
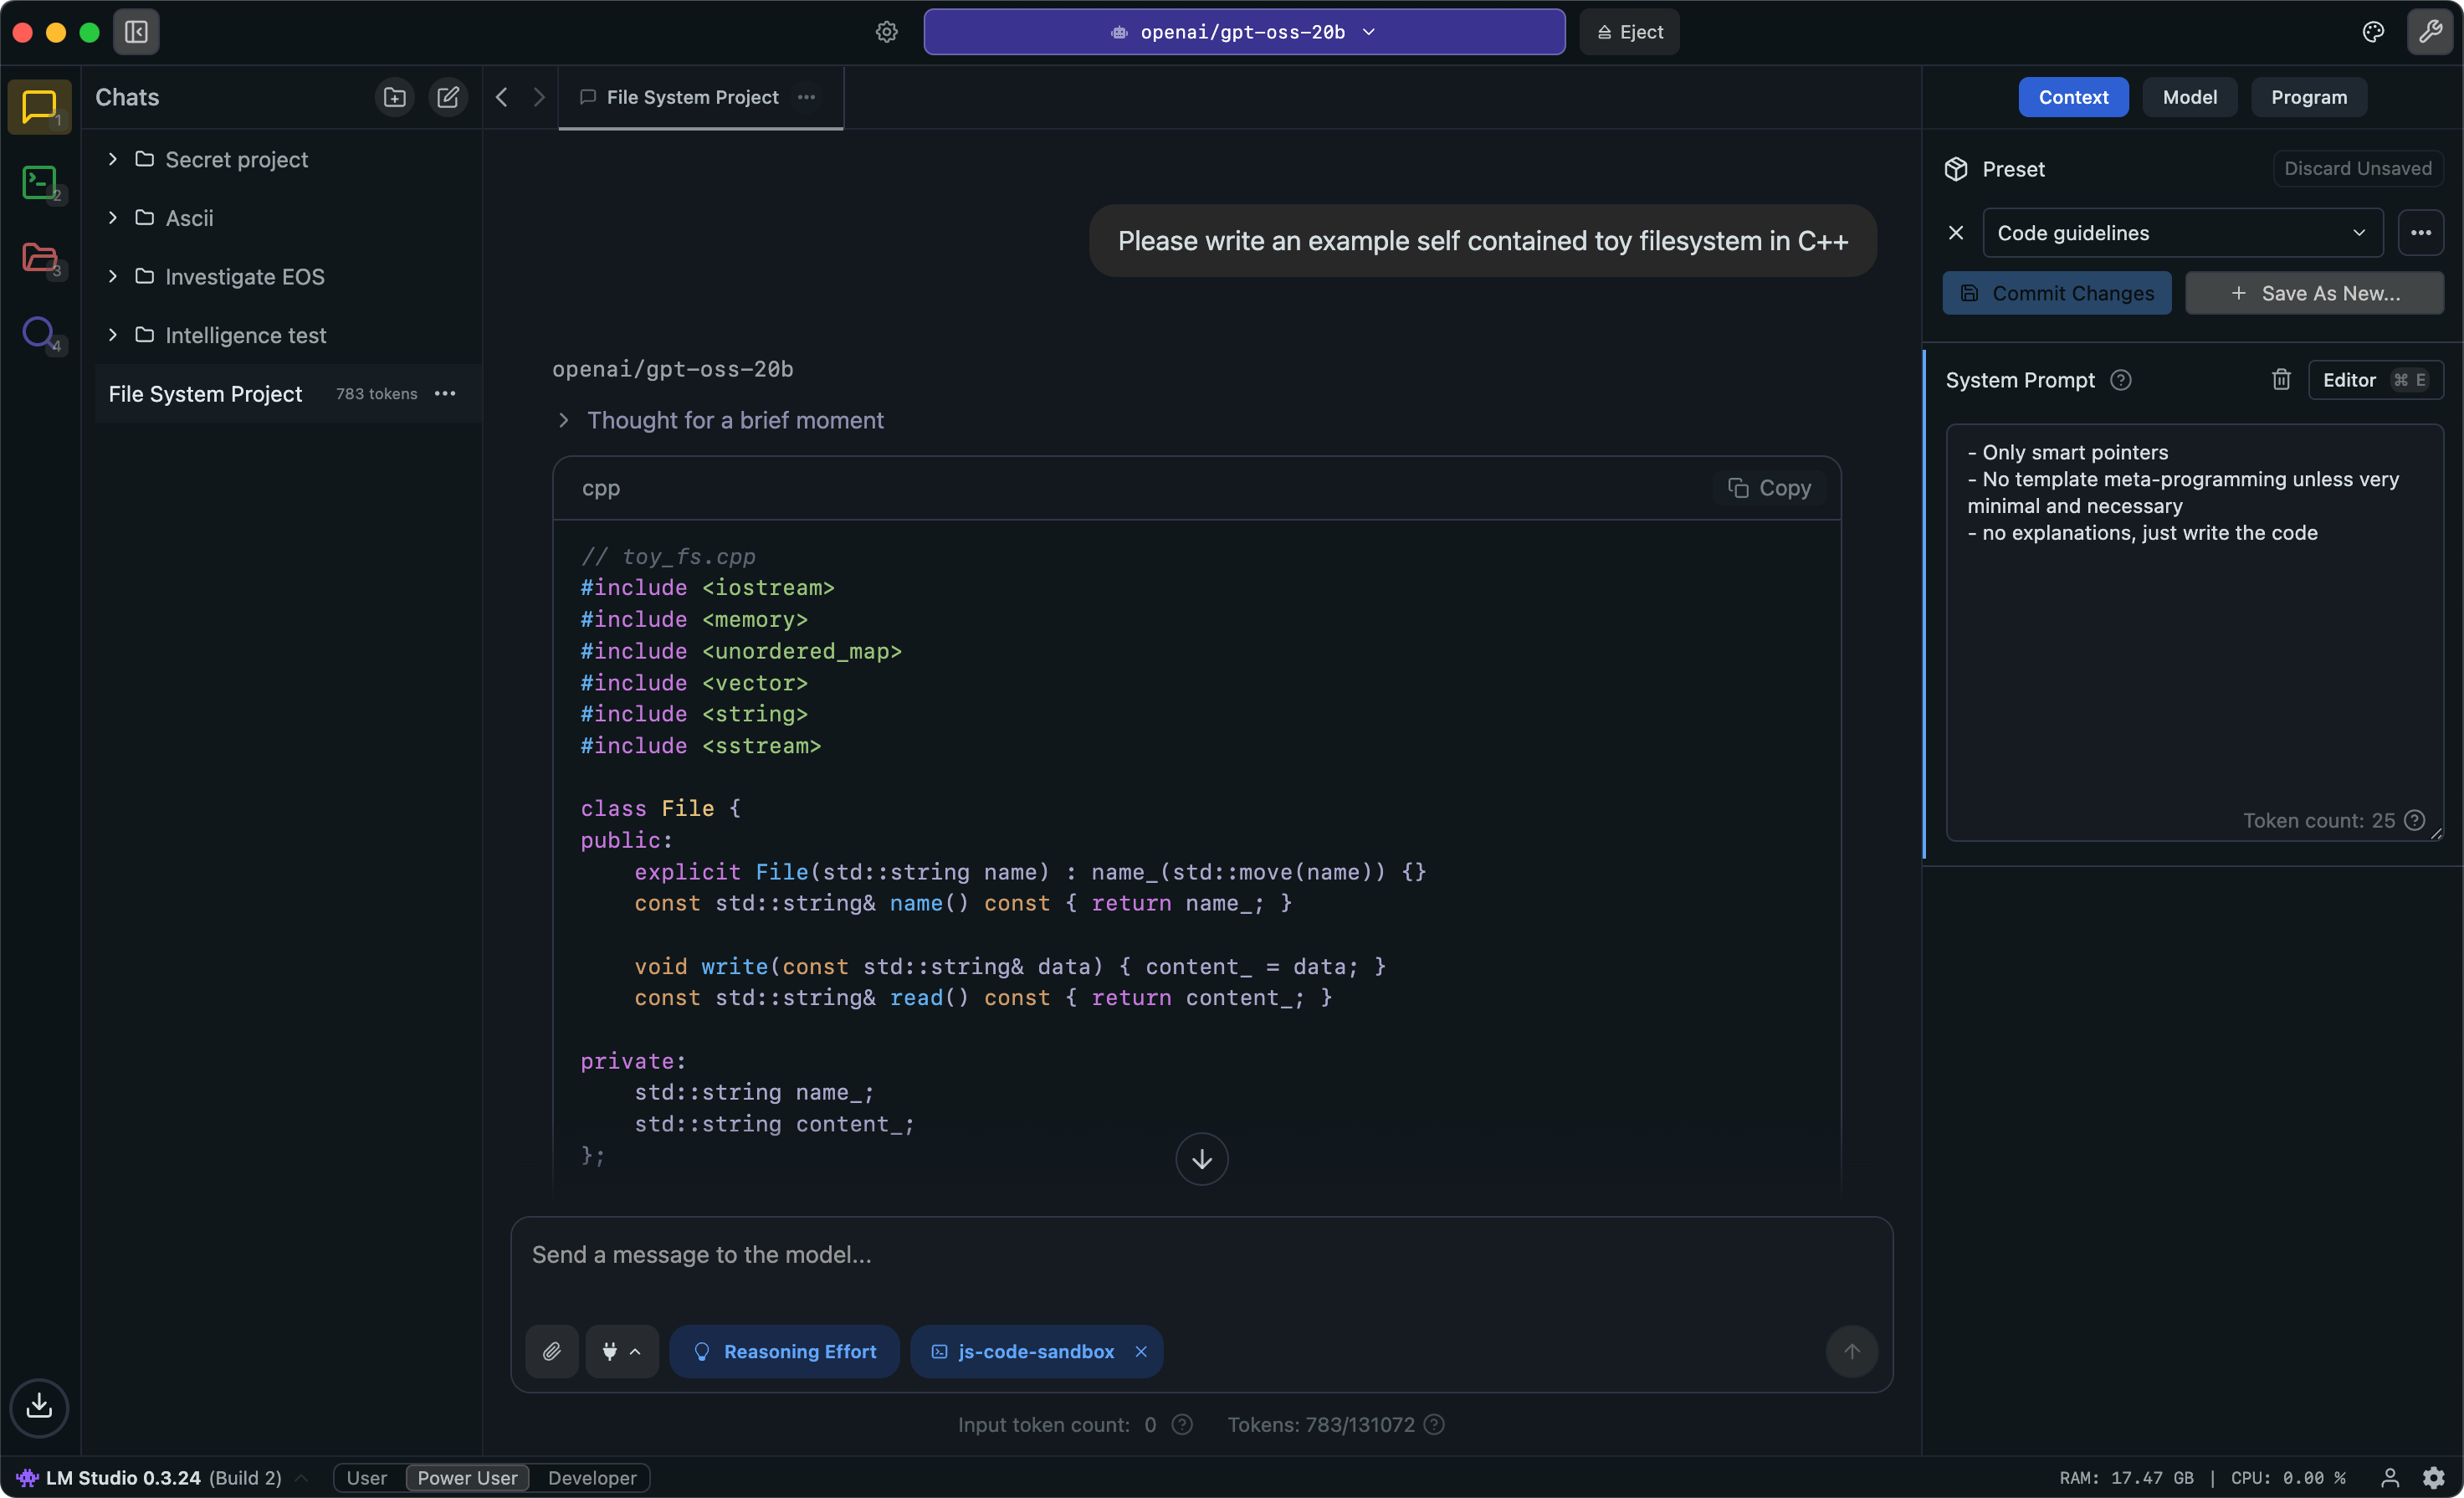
2026 年現在、ローカルLLMを起動するハードルは「ChatGPT のアプリをインストールする」のとほぼ同じレベルまで下がっています。以下の 2 ツールが事実上の標準です。
ツール選び:Ollama / LM Studio
| 項目 | Ollama | LM Studio |
|---|---|---|
| 形態 | CLI + ローカル API サーバー | デスクトップ GUI |
| 向く人 | 開発者、自動化に組み込みたい人 | まず触ってモデルを比較したい人 |
| モデル取得 | ollama pull llama3.1:8b | GUI のモデル検索からダウンロード |
| 外部アプリ連携 | OpenAI 互換 API で他ツールから呼べる | OpenAI 互換 API サーバーを GUI で起動 |
| GPU 設定 | 自動配分(細かい調整は Modelfile) | スライダーで GPU/CPU 配分を可視化 |
| 対応 OS | Mac / Linux / Windows | Mac / Windows / Linux |
どちらも無料で、用途で使い分けるのが現実解です。「アプリから AI 機能を呼ぶプロダクトを作る」なら Ollama、「まず触って比較する」なら LM Studio が入りやすい選択肢です。

公式サイト
Ollama
ollama.com — CLI 1 コマンドでモデル取得と起動。OpenAI 互換 API で 他アプリから呼び出せる。
https://ollama.com/ ↗

公式サイト
LM Studio
lmstudio.ai — デスクトップ GUI。モデル検索・チャット・API サーバー起動を 1 画面で。
https://lmstudio.ai/ ↗
最初の1モデルの動かし方
手順は次の 3 ステップです。
- Ollama か LM Studio をインストールする
- コマンド
ollama run qwen3:8bなどでモデルをダウンロード & 起動する - ターミナルか GUI から会話を開始する
8〜12GB VRAM 環境であれば、 qwen3:8b か llama3.1:8b がバランスの良い出発点になります。
モデルファイルは 7〜8B クラスで 4〜6GB、70B クラスで 40〜50GB と大きいため、家庭の回線でも 10 分〜数時間かかります。社内環境では、初回ダウンロード時のトラフィックを情シスに事前共有しておく方が無難です。
08.ローカルLLMの利点
| 利点 | 中身 | BtoBでの効き方 |
|---|---|---|
| データが外に出ない | 推論時に重みもデータも自社内に留まる | 顧客名・契約・コードなど、API に送りづらい情報を扱える |
| ランニングコストが固定費 | 電気代+ハード原価のみ、API トークン課金が発生しない | 大量バッチや常時起動アプリで API 課金が見合わない領域に向く |
| ファインチューニングを無料で回せる | LoRA / QLoRA で家庭用 GPU でも追加学習ができる | PoC〜本番のチューニング試行に外部費用が発生しない |
| オフラインで動く | 回線が無くても推論できる | 現場端末・飛行機・船舶・閉域網などネット不可環境で使える |
| モデル選択の自由度 | 用途別に小型・大型・推論型・コード特化を切り替えられる | 1 ベンダーに縛られず、業務ごとに最適なモデルを当てやすい |
| バージョン固定が効く | クラウド側の挙動変更で出力が変わる事故が起きない | 規程化された業務フローで「同じ入力には同じ出力」を維持しやすい |
実務上もっとも効くのが、ファインチューニング(追加学習)を無料で何度でも試せる点です。 Unsloth や Hugging Face の TRL を組み合わせれば、8B クラスのモデルなら 12GB VRAM の家庭用 GPU でも QLoRA で学習が回ります。クラウド API のファインチューニングは 1 回数千円〜数万円かかるため、業務データで何十回も試行錯誤するフェーズでは、ローカルLLMの方が圧倒的にコストが下がります。
ファインチューニング・RAG・プロンプトの使い分け|社内AIで何を選ぶか
ファインチューニングは「振る舞いを学ばせる」手段。ローカルLLMで無料化される位置づけとセットで読むと使いどころが見えます。
09.ローカルLLMの未来:クラウド最先端が降りてくる
2026 年時点でクラウドの最上位(Claude 4.7、GPT-5、Gemini 3)にローカルLLMは届いていません。しかし過去数年の流れを見ると、クラウドで最先端だったモデルが、ローカルで同等性能に到達するまでのタイムラグは確実に短くなってきています。実際の公開日ベースで並べると次の通りです。
日付は各モデルの公開ベース。性能の「到達」は MMLU・HumanEval・GPQA など主要ベンチマークの集計値で見たもので、タスクや評価方法によって前後します。Claude 4 / GPT-5 級のローカル到達時期は 2026 年 5 月時点の見立てです。
タイムラグは GPT-4 級の 13 ヶ月から、o1(推論モデル)級の 4 ヶ月まで縮みました。要因は次の 3 つです。
- オープンウェイトモデルの公開競争:Meta / Alibaba / DeepSeek が四半期単位で新モデルを公開し、クラウドへの追随期間が短縮
- 蒸留(Distillation)の活用:巨大な先行モデルから知識を「圧縮」して 小型モデルを作る手法が成熟。Qwen 系・DeepSeek 系が積極採用
- 推論最適化とハードウェアの大容量化:FlashAttention・speculative decoding・MoE と、Apple Silicon の統合メモリ・NVIDIA DGX Spark・AMD Strix Halo といったメモリ大容量ハードが、家庭用機での 70B〜400B 級稼働を後押し
Anthropic / OpenAI / Google などが新モデルをリリース(年 1〜2 回)
Meta / Alibaba / DeepSeek などが 4〜13 ヶ月遅れで同水準を公開
コミュニティが Q4・MoE・推論最適化で家庭用 GPU に乗せる
クラウド側はさらに先のモデルへ。① に戻り周期が再開
周期はタイムラグの短縮傾向と連動。プロセス世代・データ枯渇・蒸留技術の進歩で短縮・延長があり得ます。
AI ベンダー側の進化速度が突然鈍化しない限り、クラウドはこれからも先を走り続けます。一方、ローカル側のタイムラグは GPT-4 級の 13 ヶ月から o1 級の 4 ヶ月まで縮みました。同じ傾向が続くなら、Claude 4 / GPT-5 級が手元の Mac Studio やゲーミング PC で当たり前に動くのは、2026〜2027 年のどこかで現実になりそうです。
10.よくある質問(FAQ)
ローカルLLMはクラウド型より精度が低いですか?
最先端のクラウド最上位(Claude 4 系・GPT-5・Gemini 3)と、家庭用 PC で動かせるサイズのローカルLLMには、依然として大きな差があります。一方、業務サーバー級で 70B〜400B クラスのオープンウェイトを動かす場合は、タスクによってはクラウド上位に肉薄します。導入検討時は、自社のユースケースに近い評価で実機テストするのが安全です。
ローカルLLMはどれくらいのスペックがあれば実用域ですか?
8GB〜12GB の VRAM(RTX 4060 / 4070 クラス)があれば、Q4 量子化された 7〜8B モデルを実用速度で動かせます。30B クラスは 24GB VRAM、70B クラスは 24〜32GB VRAM か Apple Silicon の 64GB 以上の統合メモリが目安です。VRAM・統合メモリの容量が最大のボトルネックになります。
量子化すると精度はどれくらい落ちますか?
Q4_K_M(4bit)は、品質低下が小さく容量も小さい現状の主流です。多くの業務用途では人間が体感できるほどの差は出ません。Q2〜Q3 は容量はさらに小さいものの、長文や複雑な指示で破綻が見えることがあります。品質重視なら Q5_K_M や Q8 まで上げ、ぎりぎりの容量に詰めたい時だけ Q3 を試す、という運用が安全です。
なぜ NVIDIA より Apple Silicon が話題になるのですか?
Apple Silicon は CPU・GPU・Neural Engine が同じメモリプールを共有する統合メモリ構造を採用していて、Mac Studio(M4 Ultra)で最大 192GB、Mac Pro(M4 Ultra)で最大 512GB の大容量メモリを単機で積めます。NVIDIA のコンシューマ向け単体カードは VRAM 32GB 程度が上限なので、「70B クラス以上を 1 台で動かす」用途では Apple Silicon が現実解になりやすいです。生のトークン生成速度は NVIDIA ハイエンドの方が速いものの、メモリに乗りきること自体が「動く / 動かない」を分けます。
ローカルLLMでファインチューニングは本当に無料でできますか?
ハードを所有していれば、電気代と時間以外の追加費用は発生しません。 Unsloth や Hugging Face の TRL を使えば、QLoRA で 12GB VRAM の家庭用 GPU でも 8B クラスのモデルを学習できます。クラウド API のファインチューニングは 1 回あたり数千円〜数万円かかるため、業務データで何十回も試行錯誤するフェーズではローカルLLMの方が圧倒的にコストが下がります。
結局、クラウドとローカル、どちらを選べばよいですか?
「ローカル vs クラウド」の二択ではなく、データの性質とタスクの難易度で使い分けます。社外に出せないデータ・大量バッチ処理・固定費化したい用途はローカル、最先端の複雑タスク・週次の単発調査・コーディングエージェントの常用などはクラウド、という形で組み合わせる構成が、2026 年の業務利用では現実解になっています。
11.まとめ
ローカルLLMは、Llama・Qwen・Gemma などのオープンウェイトモデルを Ollama や LM Studio で手元のマシン上で動かす方式です。素の性能ではクラウドの最上位に届かない一方、データを外に出さずに済むこと、トークン課金が発生しないこと、ファインチューニングを無料で繰り返せることが大きな利点です。スペックの目安は 8〜12GB VRAM で 7〜8B、24〜32GB VRAM で 30B〜70B、Apple Silicon の統合メモリは大きいモデルを動かす土俵で有利です。今後しばらくは推論速度よりメモリ容量の戦いになりやすく、クラウド最先端は 1〜2 年遅れでローカルに降りてくる周期が続きそうです。「2〜3 年後にいまのクラウド最強級が手元で動く」前提で、社内 AI の運用設計を組んでおくと、移行が滑らかになります。
社内向けローカルLLMの導入を相談しませんか
社内データを外に出さないAI活用、オープンウェイトモデルの選定、ファインチューニングのPoC、社内サーバー構成のご相談を承ります。お気軽にお問い合わせください。
