
Codex Securityで
セキュリティチェック
AIエージェントがコードを書く量が増えると、セキュリティリスクも上がります。この状況に向けてOpenAIが提供しているのがCodex Securityで、公式ドキュメントでは、セキュリティ・エンジニアリング両チームが脆弱性を見つけ、確認し、修正するためのアプリケーションセキュリティのエージェントだと説明されています。
日本時間の2026年7月29日には、これをターミナルから呼ぶためのnpmパッケージ@openai/codex-securityが公開されました。同パッケージのライセンスはApache-2.0で、openai/codex-securityのリポジトリにCLIとTypeScript SDKのコードが置かれています。バージョンは7月30日時点で0.1.4です。
- 検出だけでなく、検証(本当に成立するか)とパッチ候補の生成までを1つの流れで扱います。差分だけを対象にしたスキャンやSARIFでの書き出しに対応し、CIやコミット前フックにも組み込めます
- 公開されたのはCLIとSDKで、判定するのはOpenAIのモデルです。ローカルだけで完結する検査ツールではなく、スキャンには公式ドキュメントが要求する「Codex Securityへのアクセス」が別に必要です
- スキャンは対話的な承認を求めず、利用者のOS権限で動きます。信頼できるリポジトリだけを対象にし、渡す環境変数を絞る運用が前提になります
01.3種類の利用方法
Codex Securityという名前は、同じエージェントを呼ぶ複数の使い方をまとめた呼び方です。公式ドキュメントによると利用方法は3種類あり、誰でも入れられるものと、利用に条件が付くものが混在しています。「オープンソース化された」という話だけを見て自分の環境でそのまま動くと考えると、実態とずれます。
| 利用方法 | 何をするもの | 提供状態 |
|---|---|---|
| プラグイン | CodexやChatGPTのデスクトップアプリから対話的にスキャンする | 一般公開。Codex内のプラグイン一覧から導入する |
| CLI・TypeScript SDK | ターミナルやプログラムから、繰り返し同じ手順で回す | パッケージは公開。スキャンにはCodex Securityへのアクセスが必要 |
| クラウド | GitHubのリポジトリを接続し、コミットを追いながら継続的に見る | リサーチプレビュー。Codexのクラウド側で設定する |
同じドキュメントによると、CLIとSDKのパッケージ自体は公開されていますが、スキャンの実行には別途「Codex Securityへのアクセス」が要ります。取得の具体的な条件までは明記されていないため、対話的に試すだけなら、まずプラグインを入れるところから始められます。
デスクトップアプリでプラグインを入れる
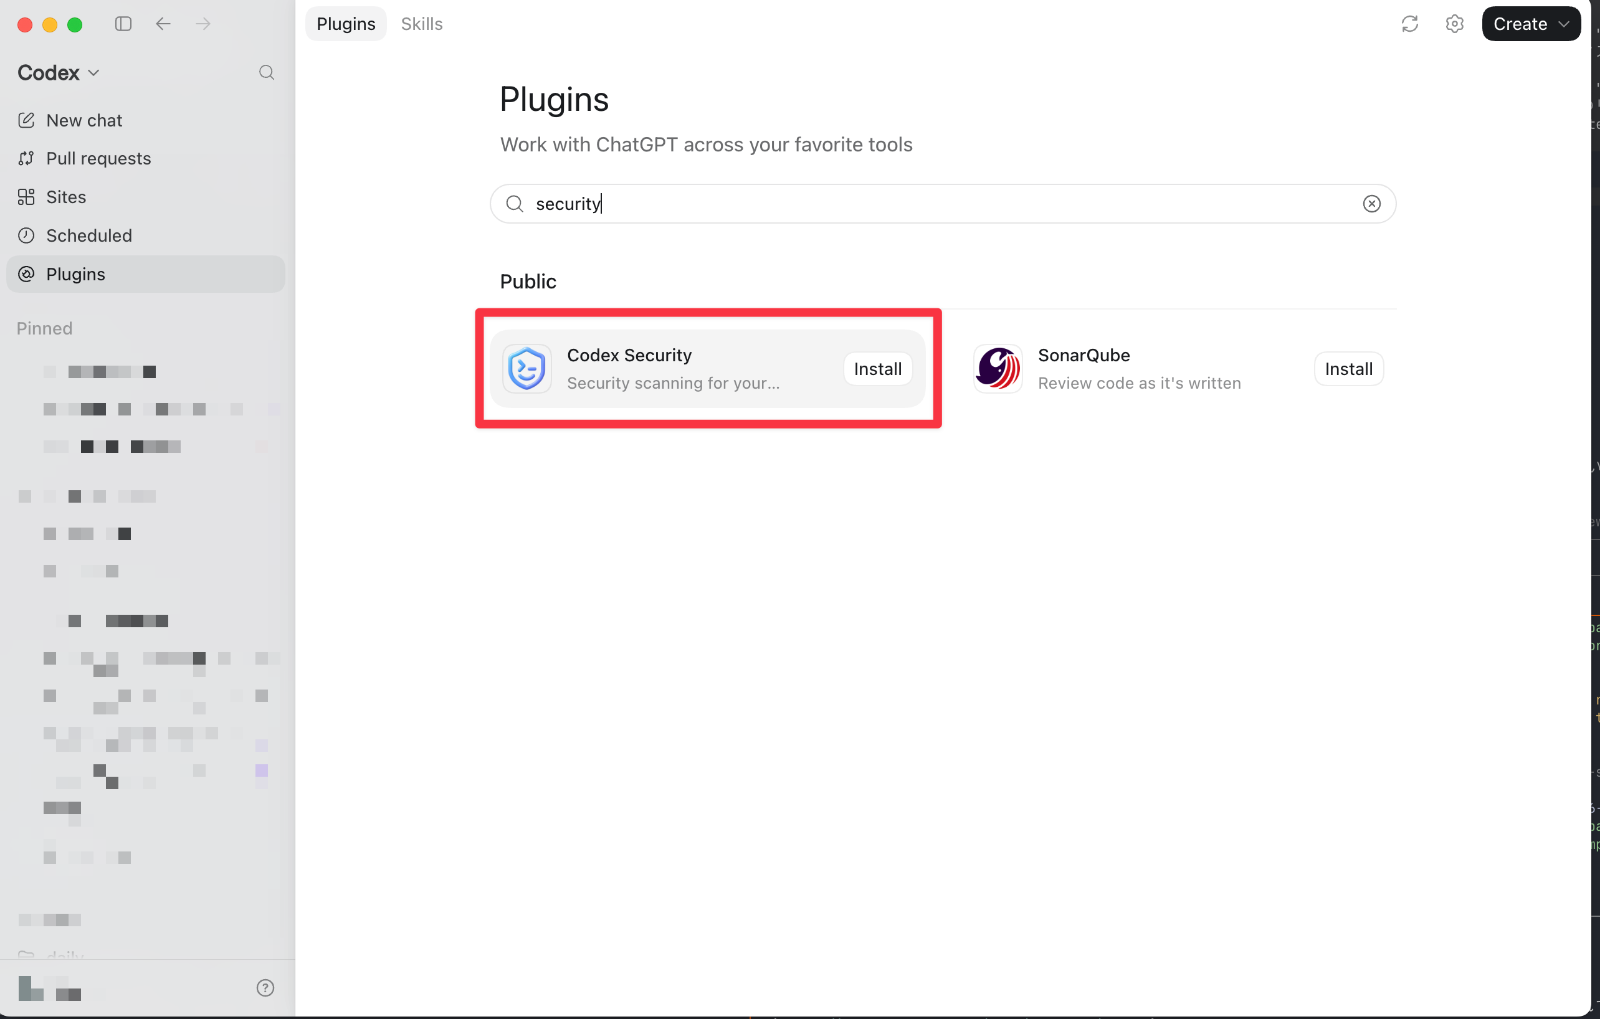
一般公開されているプラグインは、Codexのデスクトップアプリから入れられます。左メニューの「Plugins」を開き、検索して「Codex Security」を選んでInstallを押します。
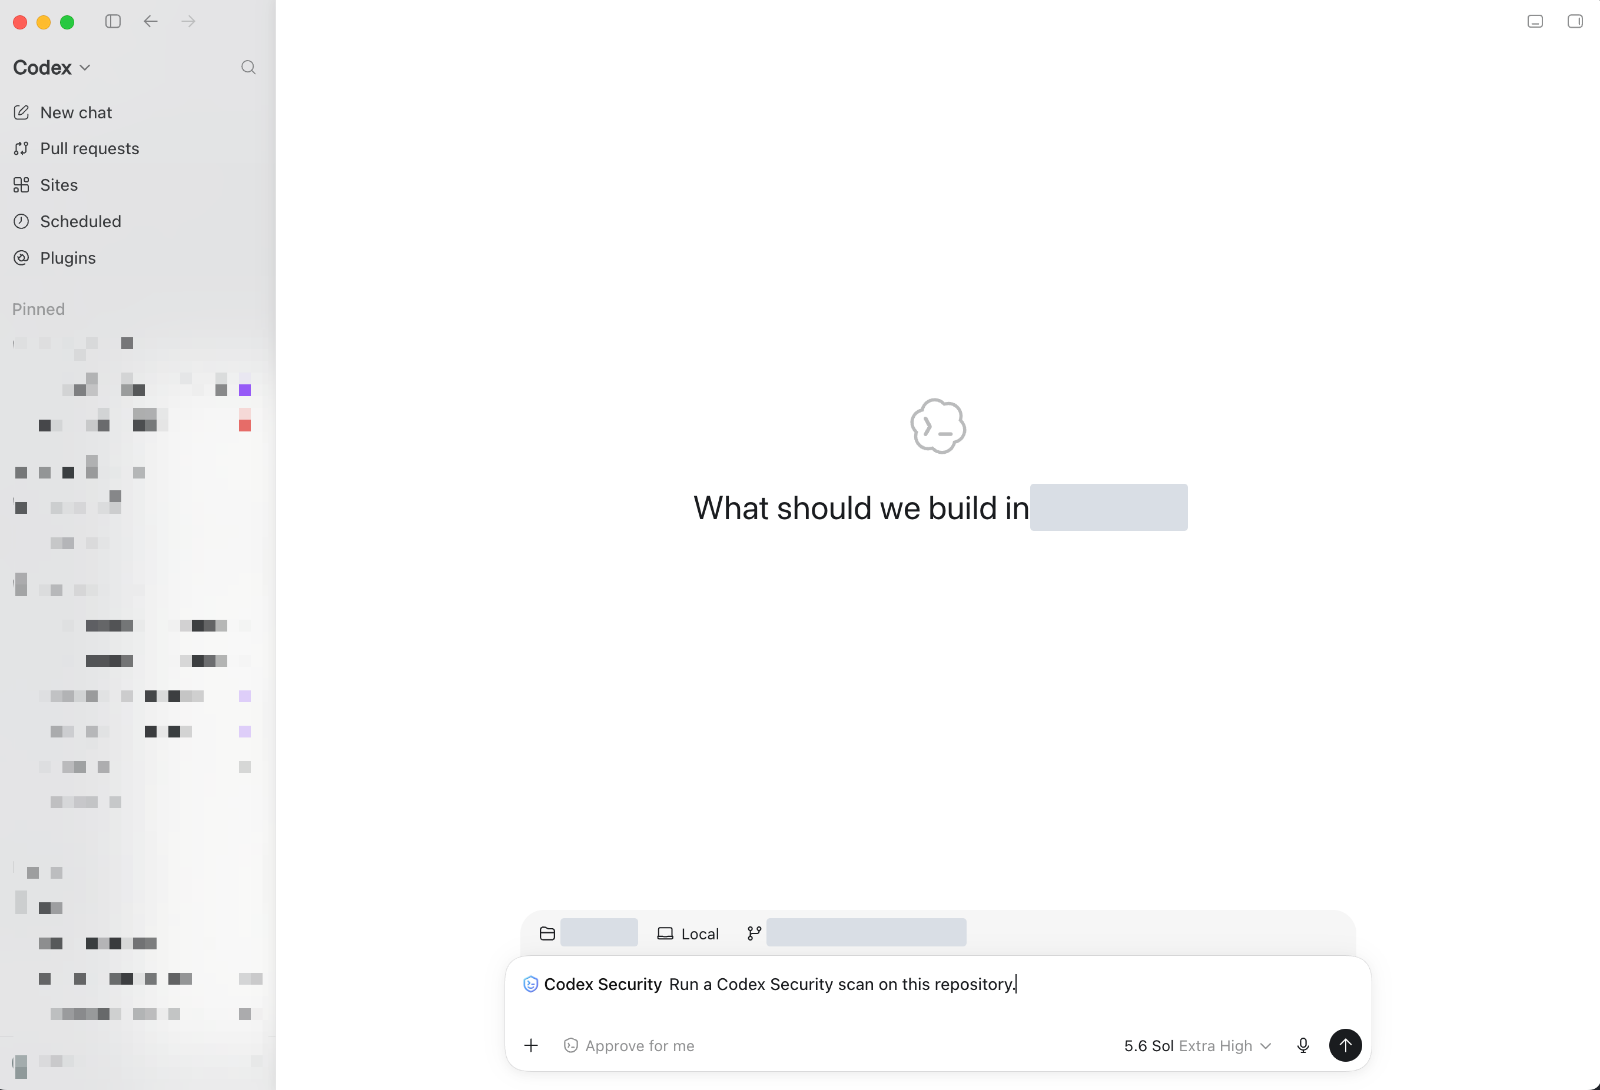
入れたあとは新しいチャットでプラグインを指定し、スキャンを頼みます。次の画面では、入力欄に「Codex Security」のプラグインが付いた状態でRun a Codex Security scan on this repository.と指示しています。モデルの表示が5.6 Sol・Extra Highになっている点も、CLIの既定(gpt-5.6-sol・推論の強さxhigh)と揃っています。
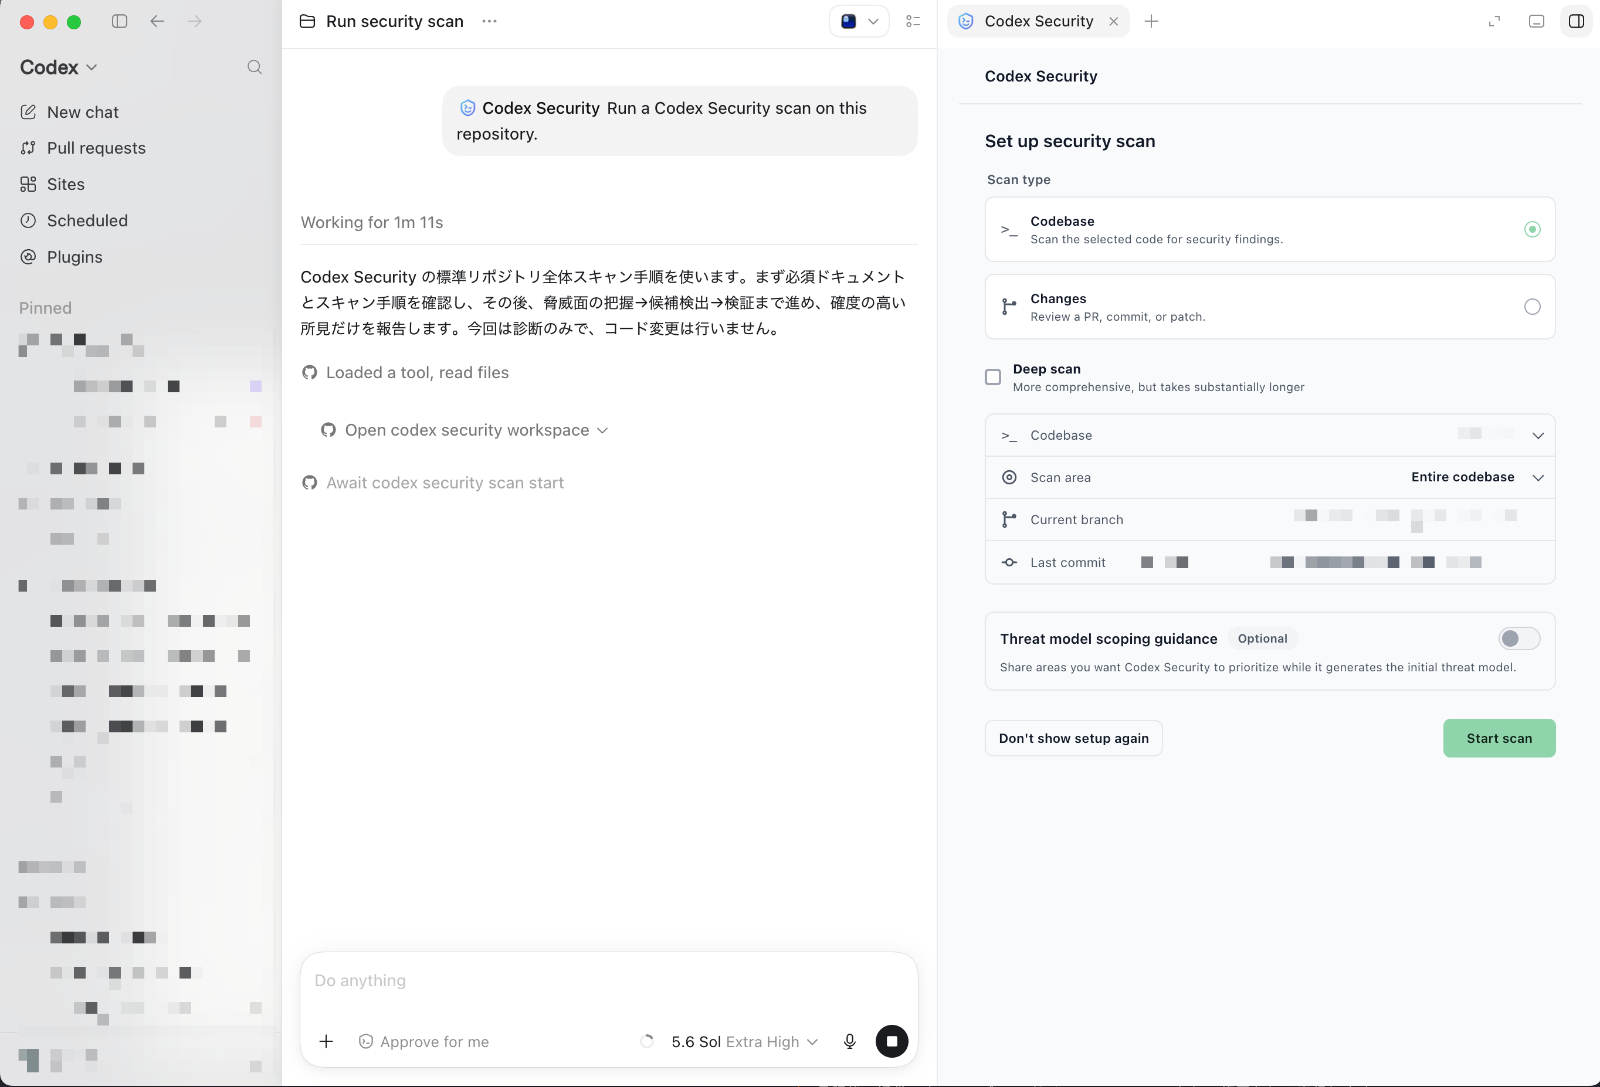
依頼すると、右側にスキャンの設定パネルが開きます。対象をコードベース全体にするか変更分(プルリクエスト・コミット・パッチ)にするか、深いスキャンを使うか、脅威モデルで優先して見てほしい範囲を渡すかを選んでからStart scanで走らせる流れです。
なお、ここでスキャン対象にしているのは、この記事のために検証用に用意したリポジトリです。
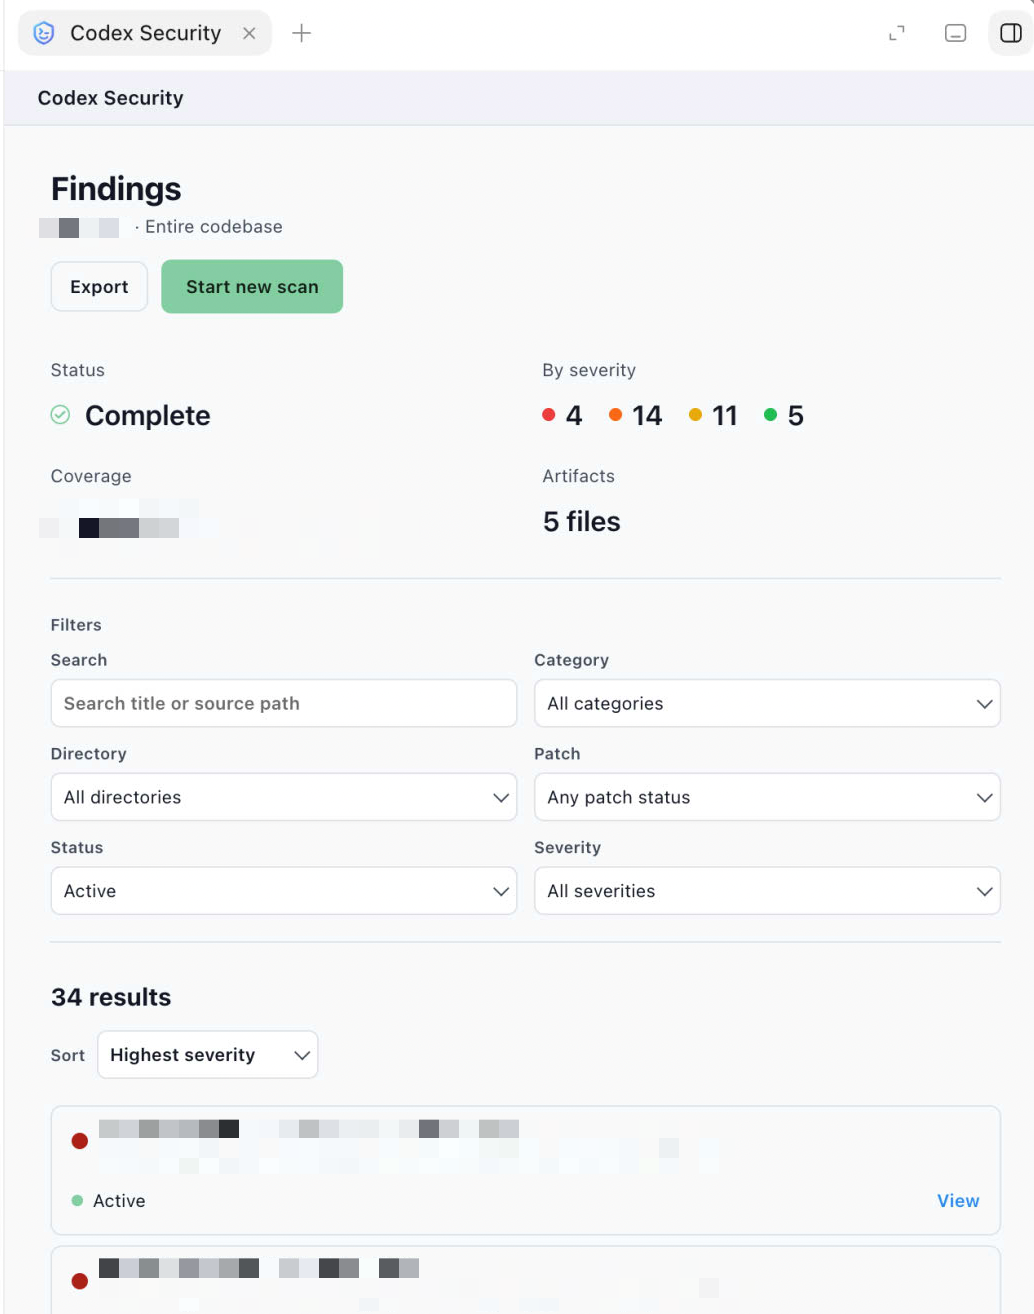
スキャンが終わると、同じ画面のFindingsで結果を確認できます。重要度別の件数・カバレッジ・対象ファイル数の集計と、検出を絞り込むフィルタ、重要度順に並んだ一覧が表示される構成です。個々の検出の中身(後述のfindings.jsonに対応する情報)は、一覧から選んだ先で確認します。
クラウド側は、リポジトリを接続して継続的に見る使い方になります。設定を始めると、まず「研究プレビュー」のバッジとともに、参加規約(Research Preview Program Agreement)への同意を求められます。
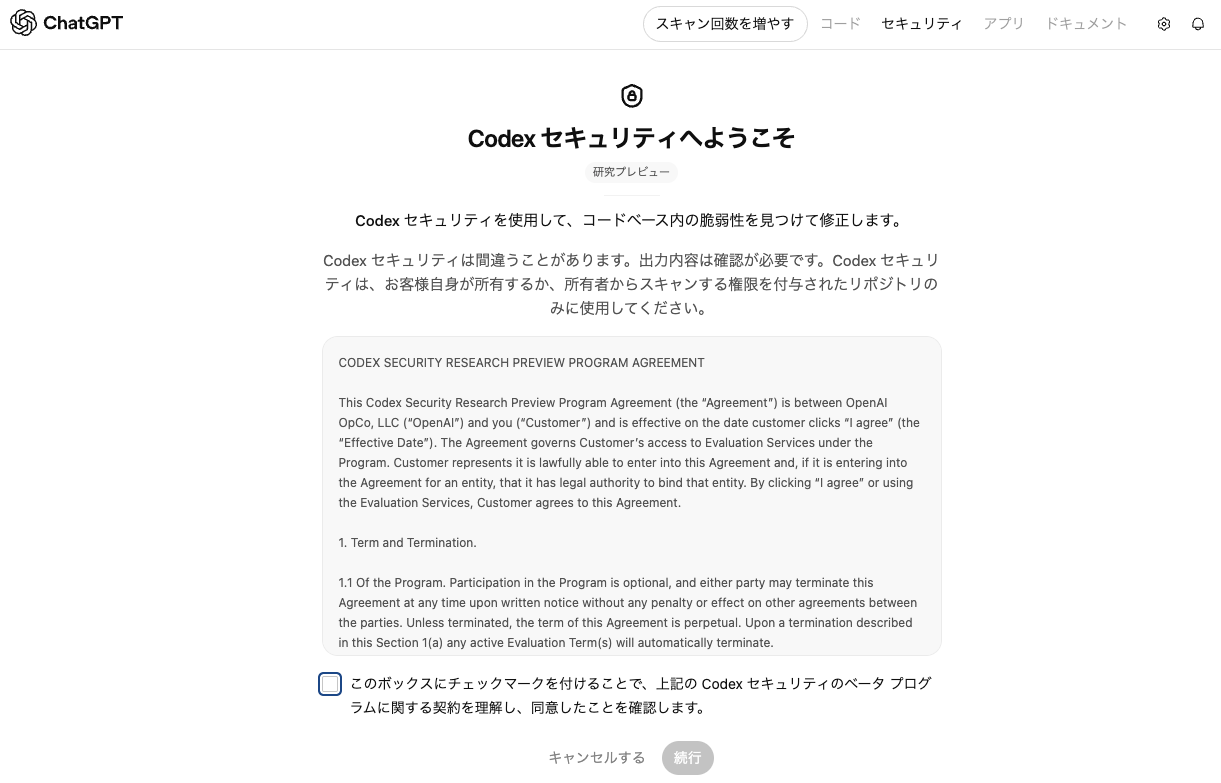
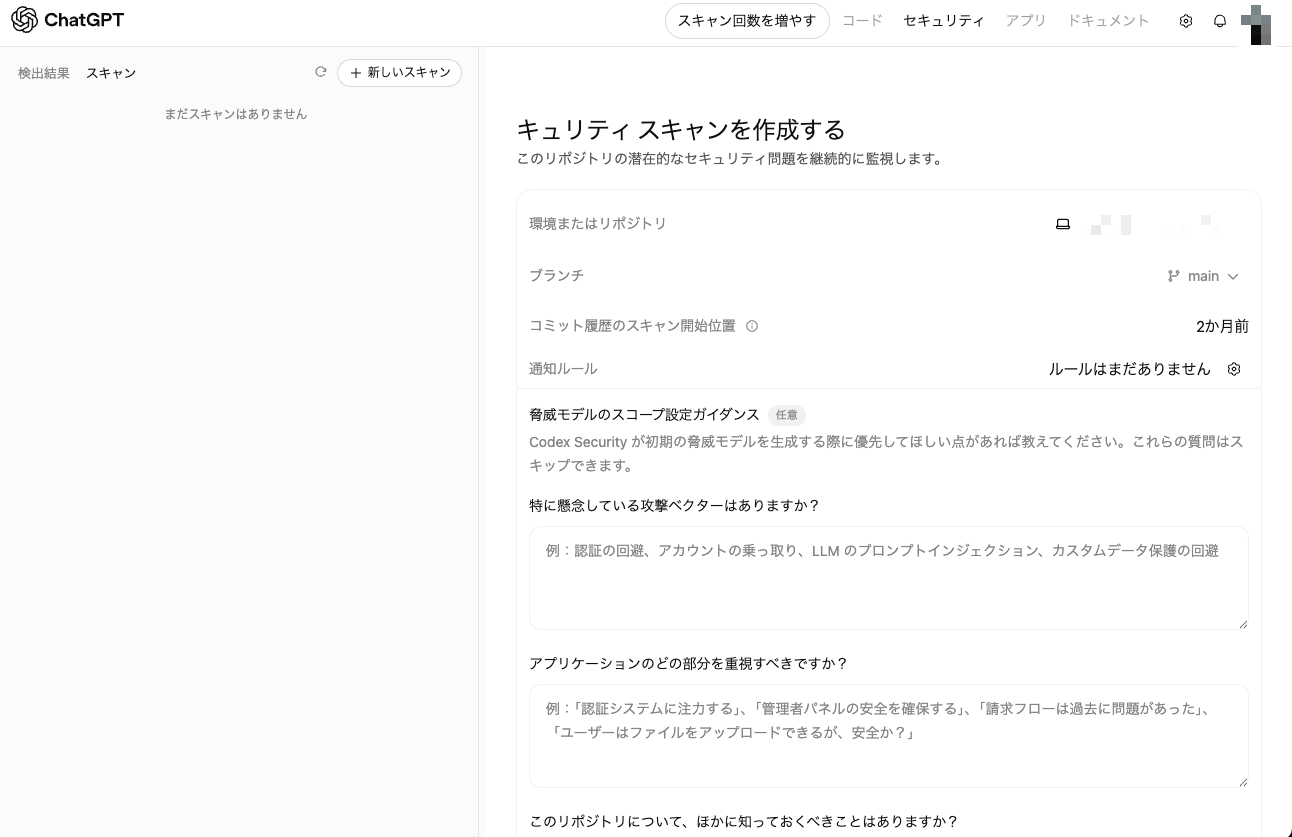
公式のセットアップ手順では、先にCodexのクラウドを設定し、GitHubの組織とリポジトリ、対象ブランチ、遡る期間を選ぶ流れが示されています。最初のスキャンは過去分の取り込みを伴うため、リポジトリが大きい場合や期間を長く取った場合は数時間かかることがあると明記されています。同じページでは、最初の検出が出たあとに脅威モデルを自社のアーキテクチャや信頼境界、事業上の文脈に合わせて更新することが勧められています。ここを放置すると、重要度の並び順が自社の感覚と合わないままになります。
Codex自体の歩みを追いたい場合は、OpenAI Codex 進化の年表|2021年から2026年9月までで提供形態の変化を時系列にまとめています。
02.オープンソースになった範囲
オープンソースで公開されたのは、スキャンを呼び出す側です。リポジトリのREADMEは@openai/codex-securityを、コードの脆弱性を見つけ、検証し、修正するためのCLIとTypeScript SDKだと紹介しています。同リポジトリのLICENSEはApache License 2.0です。
動く条件とライセンス
動かすために必要なものは、READMEとパッケージのREADMEに次のとおり挙げられています。
- Node.js:22.13.0以降の22系、24系、または26系
- Python 3.10以降:スキャンと結果の書き出しで使います。3.10の場合は
tomliを入れます。別のインタプリタを使うなら--python・SDKのpythonPath・PYTHONで指定します - Codex Securityへのアクセス:公式ドキュメントが「スキャンの実行には必要」とする条件で、取得方法の詳細は明記されていません
- 資格情報:ChatGPTのサインイン、または
OPENAI_API_KEY/CODEX_API_KEY - 対応OS:macOS・Linux・Windows
判定の中身はモデル側にあります。パッケージのREADMEには、スキャンが既定でgpt-5.6-solを最も高い推論設定で使い、提供元はOpenAIであることが明記されています。つまり手元で動くのは進行管理と結果の整理までで、脆弱性かどうかを判断するのはOpenAIのモデルです。ライセンスとしてのApache-2.0の義務は、オープンソースライセンスの種類と違い|MIT・Apache・GPL・AGPLの義務と商用利用の可否で条文ベースに整理しています。
OSSであることの実利
コードが読めるからといって、誰でもすぐスキャンを動かせるわけではありません。それでもクライアント側がApache-2.0で公開されたこと自体には、独自の実利があります。
- 実行前に中身を読んでからCIに組み込める:後述するとおり、スキャンは対話的な承認を求めず利用者のOS権限で動きます。CIのシークレットにアクセスできる状態で走らせる前に、何が実行されるのかをソースコードの段階で確認できます
- CLIとSDK自体の利用に対価は発生しない:Apache License 2.0は、著作権表示さえ残せば商用でも無償で使える許諾型のライセンスです。対価が不要なのはコードの利用までで、判定を担うOpenAIのモデルを動かすにはCodex Securityへのアクセスが別に必要で、使った分のトークン費用もかかります
- 改変・同梱してもコピーレフトの義務を負わない:GPL系のようなコピーレフトの規定がないため、同梱以外のスキルに差し替えたり、自社のCI基盤に組み込んだ形をそのまま使っても、変更点を公開する義務は生じません
OSS化が変えたのは、実行前に中身を検証できることと、クライアント側を自由に改変・同梱できることです。判定を担うモデルへのアクセスと、その費用は、冒頭で触れたとおり別枠のままです。
ここに至る経緯も公式発表として公開されています。OpenAIは2025年10月にAardvarkというセキュリティ研究のエージェントを発表し、2026年3月にCodex Securityとしてリサーチプレビューを出しています。CLIとSDKの公開は、その延長で開発の手元側に降りてきたものと整理できます。
03.検出・検証・パッチという流れ
公式ドキュメントは、処理を3つの段階に分けて説明しています。特徴は真ん中の検証で、候補を出した時点で人に見せるのではなく、隔離した環境で成立するかを確かめてから提示すると説明されています。誤検知の山をレビュー担当に渡さないための設計です。
リポジトリをコミット単位で読み、そのリポジトリ向けの脅威モデルに沿って候補を挙げます
挙がった候補を隔離した環境で確かめ、成立するものだけを結果に出します
修正案を作り、根拠と一緒に提示します。適用の判断と確認は人が行います
CLIでは、検証とパッチ生成を validate・patch コマンドとして個別に呼び直せます。
パッチは提案であって、そのまま入れるものではありません。リポジトリのセキュリティポリシーにも、安全に動かすための項目として、適用やマージの前にパッチを確認することが挙げられています。
04.検査の手順は13個のスキルとして読める
判定はモデルが行いますが、どういう順序で何を根拠に判断させているかは読める形で同梱されています。CLIに同梱されるプラグインの構成はリポジトリのplugin-files.jsonに列挙されていて、skills/<名前>/SKILL.mdの形で13個のスキルが入っています。判定基準を共有するreferences/のMarkdownも9本あります。
| スキル | 担当する段階 |
|---|---|
| threat-model | リポジトリ単位の脅威モデルを作る・更新する |
| security-scan | 標準のスキャンを進行させる |
| security-diff-scan | 差分(プルリクエスト・コミット)を対象にする |
| deep-security-scan | 繰り返し探索する深いスキャン |
| finding-discovery | 候補を挙げる |
| validation | 候補が成立するかを確かめる |
| attack-path-analysis | 到達経路をたどり、深刻度を決める |
| triage-finding | 検出の扱いを判断する |
| fix-finding | 修正パッチを作り、直ったことを確かめる |
| propose-security-hardening | 構造的な強化を提案する |
| track-findings | 前回のスキャンとの対応を追う |
| vulnerability-writeup | 報告としてまとめる |
| define-security-policy | 対象のセキュリティ方針を定める |
中身は手順書です。threat-modelのSKILL.mdは、脅威モデルで明らかにすべきものとして、重要な資産や権限・信頼境界・攻撃者が制御できる入力・コードが守るべき不変条件・影響の大きい失敗の形を挙げています。同じファイルには、リポジトリのAGENTS.mdやSECURITY.mdが製品面・信頼境界・攻撃者の入力について十分に具体的なら、それを脅威モデルとして使えるとも書かれています。
fix-findingのSKILL.mdは、修正結果を判断する順序を上から6つ並べ、前の条件を後の条件のために譲らないと定めています。「最小」の意味も、行数が少ないことではなく、前の条件をすべて満たす範囲でリポジトリの書き方に沿った最小の変更だと明記されています。
- 現状の分類が先に来ます:脆弱なのか、すでに安全なのか、判断できないのかを正しく分ける
- 次に境界が閉じているか:破れていた境界を完全に閉じる
- そのうえで既存の動作と互換性を保ち、リポジトリのチェックが通り、書き方の慣習に沿い、変更範囲は必要なぶんだけにする
読めることの実利は2つあります。ひとつは、指摘が出たときに「どの段階の判断か」をたどれること。もうひとつは、自社の基準に寄せられることです。パッケージのREADMEによると、--plugin-path(SDKではpluginPath)で同梱以外のプラグインのディレクトリを指定できます。ただし--codex経由でプラグインやマーケットプレイスの設定を上書きすることは拒否されるので、差し替えるならこの指定を使います。
05.導入と最初のスキャン
READMEに載っている導入の流れは、インストール、ログイン、スキャンの3コマンドです。ChatGPTのサインインで使うか、OPENAI_API_KEYまたはCODEX_API_KEYを環境変数で渡すかを選べます。CIでは環境変数が使われ、この場合の鍵はそのスキャンに直接渡されるだけで資格情報の保管先には残らないと明記されています。
入れる場所には注意が必要です。npm installはそのディレクトリのpackage.jsonに書かれた処理も走らせるため、スキャン対象のリポジトリの中で実行すると、まだ検査していないコード側の指定が先に動きます。公式のCI統合ガイドも、リポジトリが制御できるコードの実行を避けるため、チェックアウトより先にリポジトリの外へインストールするよう案内しています。グローバルに入れておけば、以降はcodex-securityで呼べます。なお公式ドキュメントの例はnpx @openai/codex-security ...の形で書かれているので、読み替えて使ってください。
# スキャン対象のリポジトリの外に入れる(CIではチェックアウトより先に実行する)
npm install -g @openai/codex-security

codex-security login
codex-security scan /path/to/repo

# モデルと推論の強さを指定する
codex-security scan /path/to/repo --model gpt-5.6-terra --effort high

# 使う資格情報を明示する
codex-security scan /path/to/repo --auth chatgpt
codex-security scan /path/to/repo --auth api-key
両方が使える状態だと、対話的なスキャンではどちらを使うか尋ねられます。JSON出力や自動実行では尋ねずに環境変数の鍵が優先されるため、CIの挙動が手元と変わる点は先に把握しておくと迷いません。ChatGPTのサインインを既定にしたい場合は、設定済みの鍵の環境変数を解除しておきます。
いきなり本番のスキャンを走らせる前に、--dry-runで入力の確認だけを済ませられます。公式のCLIガイドによると、この確認はネットワークに接続せず、実際に使われるモデルと推論の強さも表示します。結果の置き場所は--output-dirで指定し、 スキャン対象のリポジトリとGitの作業ツリーの外 に置く必要があります。macOSとLinuxでは、既存の出力ディレクトリが本人だけのアクセス権(chmod 700)になっていることも条件です。
# 入力の確認だけ(ネットワークに接続しない)
codex-security scan /path/to/repo --dry-run

# 結果をリポジトリ外に書き出す
codex-security scan /path/to/repo --output-dir /path/outside/repo/results

# 既にある結果を退避してから新しく書く
codex-security scan /path/to/repo --output-dir /path/outside/repo/results --archive-existingパッケージのREADMEには、結果にソースコードの抜粋や脆弱性の詳細、再現手順が含まれうるため、結果のディレクトリと保存したレポートはリポジトリの外に置き、確認する権限のある人に限って参照させると書かれています。セキュリティポリシー側でも、結果へのアクセスを絞り、保持期間を決め、共有やアップロードの前に内容を確認する運用が挙げられています。スキャン結果そのものが攻撃の手順書になりうるため、成果物の扱いはコードと同じか、より厳しく決めておくのが無難です。
06.スキャン範囲の絞り込みとdeepモード
パス・差分・作業ツリー
毎回リポジトリ全体を見るとコストも時間もかさむため、対象の指定が用意されています。公式のCLIリファレンスによると、パス指定・コミット済みの差分・作業ツリーの3つは同時には使えません。既定は標準モードで、--mode deepを付けるとより深いレビューになり、深いモードが対象にできるのはリポジトリとパスの指定だけです。
# 一部のディレクトリだけを見る(モノレポ向け)
codex-security scan . --path src --path tests

# main との差分だけを見る(プルリクエスト向け)
codex-security scan . --diff origin/main --json

# コミット前の変更(ステージ済み・未ステージ)を見る
codex-security scan . --working-tree

# より深く見る
codex-security scan . --mode deep
深いモードの内部設定は、パッケージのREADMEに既定値が示されています。並列に動く探索の担当数は使える並列度の半分で、最小1・最大6、繰り返しても新しい発見がなければ6回で打ち切り、探索の実行は最大60回までという値です。ただし、CLIとSDKからのスキャンは独立した設定領域を作るため手元の設定ファイルを読み込まず、 単体のCLIから深いモードの内部設定を変えるフラグは用意されていません 。深く見たいときはこの既定のまま走ると考えておきます。
設計資料を読ませる
判定の精度を上げる手立てとして、設計資料や脅威モデルを渡す指定もあります。パッケージのREADMEによると、--knowledge-baseはファイルでもディレクトリでも指定でき、ディレクトリは再帰的に探索されてMarkdown・テキスト・PDF・Wordのファイルが読まれます。どこが重要な資産で、どこが信頼境界なのかを人が説明できるほど、重要度の並びは自社の判断に近づきます。
codex-security scan . \
  --knowledge-base /path/to/threat-models \
--knowledge-base /path/to/architecture.pdf07.出力される成果物と終了コード
公式のCLIガイドによると、スキャンは決まった構成のファイル群を書き出します。人が読むのはreport.mdで、機械的に扱うならfindings.jsonを読みます。
| ファイル | 内容 |
|---|---|
| scan-manifest.json | 対象と実行側の情報 |
| findings.json | 重要度・確度・修正の手がかりを含む検出結果 |
| coverage.json | レビューがどこまで及んだかの状態 |
| report.md | 人が読むための要約 |
見落としがちなのがcoverage.jsonです。公式のCLIガイドは、カバレッジがcomplete・partial・unknownのいずれかで記録されると説明しており、CIのガイドでも、結果を確定として扱う前に後回しにされた範囲を確認するよう案内されています。「検出0件」と「見ていないので0件」を区別するための情報なので、CIのログに出しておくと後から判断できます。
終了コードも、この区別に合わせて設計されています。パッケージのREADMEによると、スキャンは既定では報告だけを行い、--fail-on-severityを付けた場合に指定した重要度以上の検出で1を返します。カバレッジが不完全な場合と実行時のエラーは2になり、 方針を満たした状態と取り違えられないようになっています 。同じREADMEには、無効な入力も2、中断が130、終了要求が143と示されています。
08.CIとコミット前チェックに組み込む
公式のCI統合ガイドでは、プルリクエストの差分を対象にし、結果をSARIF形式で書き出す形が示されています。SARIFは静的解析の結果を受け渡すための形式で、GitHubのコードスキャンなど既存の管理画面に取り込めます。パッケージのREADMEによると、SARIFが生成される場合の出力先は<scan-dir>/exports/results.sarifです。
# プルリクエストの差分をスキャンする
codex-security scan . --diff origin/main --output-dir /results --json

# SARIF に書き出す
codex-security export /results --export-format sarif --output report.sarif

# 高以上の検出でジョブを失敗させる
codex-security scan . --diff origin/main --fail-on-severity high
同じガイドでは、運用上の注意も挙げられています。
- まずは報告だけで慣らす:助言としてのスキャンから始め、そのあとで重要度による失敗の判定を足す順序が案内されています
- CLIはリポジトリの外に入れる:リポジトリ側が制御できるコードの実行を避けるため、チェックアウトより先に、リポジトリ外へインストールするよう案内されています
- フォークと依存更新ボットのワークフローは対象から外す:通常の秘密情報にアクセスできないため除外します。マージ元との共通の祖先を計算できるように、Gitの履歴は完全に取得しておきます
- 常設のランナーでは結果を退避する:
--archive-existingで前回の結果を移してから走らせます
CIより手前で止めたい場合は、コミット前のフックを入れられます。パッケージのREADMEによると、install-hookはコミットごとにステージ済みと未ステージの変更をスキャンし、既定では高い重要度の検出とスキャンの失敗でコミットを止めます。core.hooksPathの設定を尊重し、既存のフックを置き換えないと明記されています。しきい値は--fail-on-severityで変えられます。
レビューのどこを機械に任せ、どこを人が見るかという切り分けは、【2026年5月】PR レビュー工数を減らす実践と事例|AI レビューの育て方・リスク振り分けで扱っています。あわせてご覧ください。
09.複数リポジトリをまとめてスキャンする
自社に何十個もリポジトリがある状況を想定したbulk-scanも用意されています。パッケージのREADMEによると、GitHubのCLIでサインインしてから実行すると、過去90日間にプッシュがあったリポジトリを探して一覧から選べます。アーカイブ済みのリポジトリとフォークは除かれ、選んだ一覧はrepositories.csvとして保存されるため、あとから見直したり途中から再開したりできます。
# 対話的に対象を選ぶ
codex-security bulk-scan

# 一覧を渡して回す(id / repository / revision が必須列)
codex-security bulk-scan repositories.csv \
--output-dir /path/outside/repositories/security-scans --workers 4CSVで渡す場合、リビジョンは完全なコミットハッシュである必要があり、任意の列で個別に範囲やモードを狭められます。同時に走るスキャンの数は--workers、失敗時の再試行は--max-attemptsで決め、同じコマンドを再実行すると続きから再開します。台数を増やせばそのぶん費用も伸びるため、後述のコスト上限と組み合わせて使います。
10.履歴・誤検知・前回との差分
単発で検出して終わりにせず、同じリポジトリを繰り返し見る前提の仕組みが入っています。パッケージのREADMEによると、スキャン履歴はCodex Securityの作業用データベース(workbench.sqlite3)に保存され、保存先はCODEX_SECURITY_STATE_DIRで変えられます。資格情報がスキャンの設定に保存されることはないと明記されています。
# このリポジトリのスキャンを一覧する
codex-security scans list /path/to/repo

# 設定・結果・カバレッジ・成果物の場所を見る
codex-security scans show SCAN_ID

# 同じ設定で現在のコードに再実行する(修正の確認)
codex-security scans rerun SCAN_ID

# 前後のスキャンを突き合わせて差分を見る
codex-security scans match PREVIOUS_SCAN_ID CURRENT_SCAN_ID
codex-security scans compare PREVIOUS_SCAN_ID CURRENT_SCAN_ID

# 誤検知に理由を付けて記録する
codex-security findings false-positive OCCURRENCE_ID \
--reason "The route already checks permissions"比較の扱いは慎重に作られています。compareは保存された対応関係を読み、新規・継続・再発・解決・不明として報告しますが、後のスキャンが不完全な場合や元の範囲を含まない場合は、 検出が見えなくなっただけで解決とは扱いません 。誤検知の記録も、公式のCLIのFAQによると、記録した理由が同じリポジトリの次回のスキャンに文脈として渡され、パッケージのREADMEでは、その理由がまだ当てはまる場合に限って同じ検出が取り下げられると説明されています。理由を書き残す運用が、次回以降のノイズの量を決めます。
11.既定のモデルとコストの上限
費用の見当をつけるための情報は、パッケージのREADMEに集まっています。スキャンは既定でgpt-5.6-solを推論の強さxhighで使い、--modelと--effort(minimalからxhigh)で変えられます。使ったモデル・トークン数・推定費用は、スキャンのJSON結果と履歴に記録されます。推定は標準のAPIトークン価格を基準にキャッシュ分も含めて計算され、手数料や追加料金は含まないと明記されています。
並列度も費用に直結します。同READMEによると、スキャンは専用の設定で動き、1セッションあたりの同時スレッド上限は9で、この数には親のエージェントが含まれるため、任せられる作業側は最大8です。上限は最大値であって、毎回すべてが動く証拠ではないという但し書きも付いています。
# 推定費用が5ドルを超えたら止める
codex-security scan . --max-cost 5

# 同時スレッド上限を下げる
codex-security scan . \
--codex features.multi_agent_v2.max_concurrent_threads_per_session=4--max-costは、進行中の費用が指定額を超えた時点で、任せている作業も含めてスキャンを止めます。途中までの結果は保持されます。ただしCLIリファレンスと公式のCLIのFAQは、この上限が見積もりであって厳密な支出の上限ではなく、すでに送信済みの要求は上限を超えて完了しうると明記しています。大量のリポジトリを一度に回すときは、上限の指定だけに頼らず、対象を絞る指定や実行の分割と併用してください。
12.TypeScript SDKから呼ぶ
自社の仕組みに組み込む場合はSDKを使います。公式のSDKガイドによると、run()の戻り値には検出結果、カバレッジ、成果物のパス、推定費用が入り、進行の監視や中止も扱えます。パッケージのREADMEでは、1.0.0より前は小さいバージョンの更新でも公開APIが変わりうると案内されているため、固定して使うのが無難です。
import { CodexSecurity } from "@openai/codex-security";

const security = new CodexSecurity();

try {
  const result = await security.run("/path/to/repository", {
    outputDir: "/path/outside/repository/results",
    mode: "standard",
    maxCostUsd: 5,
  });

  console.log(result.reportPath);
  console.log(result.findings.findings.length);
} finally {
  await security.close();
}長く走るスキャンを扱う仕組みも用意されています。パッケージのREADMEによると、preflight()で手元の入力を検証し、onWorkerStatusとonReconnectで進行を観測し、AbortSignalで中止できます。費用の上限を超えた場合や認証が必要な場合は、それぞれ専用の例外が投げられるため、CIのジョブ側で扱いを分けられます。
なお、CLIをMCP(Model Context Protocol)サーバーとして登録することもできますが、公開されるのは読み取り専用の情報取得だけです。パッケージのREADMEによると、スキャンや認証、書き出し、検証、パッチはCLIに限られており、理由として、MCPの通信では実行中のスキャンを中止できないことが挙げられています。
13.実行時の権限とデータの扱い
導入判断でいちばん確認しておきたいのがここです。リポジトリのセキュリティポリシーは、Codex Securityが利用者のOSアカウントの権限で動くツールであり、信頼できて、かつ自分が所有するか明示的に評価を許可されたリポジトリだけを対象にするものだと述べています。評価する権限があることは、そのリポジトリを信頼できることとは別だという但し書きも付いています。
承認の扱いも明確に書かれています。スキャンは専用のファイルシステムのプロファイルとapprovalPolicy: "never"で動き、対話的な承認を求めません。--codexやSDKの設定から承認方針やサンドボックスの設定を渡しても、この制御は置き換わらず、より厳しくもならないと明記されています。ホスト側やネットワーク側で独立に効かせている制限は、引き続き有効です。
セキュリティポリシーによると、スキャンと作業用のプロセスは実行時の環境を引き継ぐことがあります。OPENAI_API_KEYとCODEX_API_KEYは作業用の仕組みが取り除きますが、GITHUB_TOKENやAWS_SECRET_ACCESS_KEYのような他の変数は残りうると明記されています。普段の開発用シェルでそのまま走らせず、必要な資格情報だけを渡した状態で実行するのが安全です。
エージェントに何をどこまで触らせるかという設計は、この種のツール全般で共通の論点です。判断の整理にはAIセキュリティ・権限設計|エージェントに何を触らせ、何を触らせないかが対応しています。
コードの送信先についても、はっきりさせておきます。判定はOpenAIのモデルが行うため、対象のコードはモデルへの要求として送られます。APIキーで使う場合、OpenAIのAPIのデータ取り扱いのガイドは、明示的に共有を選ばない限りAPIに送られたデータをモデルの学習や改善には使わないと説明しており、不正利用の監視ログは原則として最長30日保持されるとしています。ChatGPTのサインインで使う場合は、利用中のプランのデータ設定に従うため、社内で使うならワークスペースの管理者と条件を確認してから広げるのが確実です。
なお、検出の見落としや誤検知、モデル出力への攻撃であるプロンプトインジェクションは、実際の境界を越えない限りセキュリティ上の不具合としては扱わない、とセキュリティポリシーに明記されています。エージェントに読ませる入力そのものが攻撃面になるという性質は、プロンプトインジェクションとは|仕組み・直接型と間接型・なぜ防ぎきれないかで整理しています。
14.使えるようになるまでの条件
コードがApache-2.0で公開されていても、スキャンを走らせるには条件があります。整理すると次の3点です。
- Codex Securityへのアクセス:公式ドキュメントによると、CLIとSDKのパッケージ自体は公開されていますが、スキャンの実行には「Codex Securityへのアクセス」が別途必要です。公式のCLIガイドも同じ表現に留まっており、取得の具体的な条件までは明記されていません
- Trusted Access for Cyberの確認:READMEには、最良の結果のためにアカウントをTrusted Accessで確認済みにすることを推奨する注記があり、公式のCLIガイドでは、リポジトリ全体のスキャンにこの権限が必要になる場合があるとされています。制度そのものはOpenAIの発表で公開されており、身元と信頼性の確認を経た防御側にセキュリティ用途の利用を開くものです
- CI側の準備:公式のCI統合ガイドでは、APIキーを秘密情報として登録するほか、承認されたパッケージの取得元を指す
CODEX_SECURITY_PACKAGEをリポジトリの変数として設定する手順が示されています
公開リポジトリの管理者向けには、別の入手方法も用意されています。オープンソース向けプログラムの規約では、対象となるリポジトリや管理者に対して条件付きの特典としてCodex Securityへのアクセスを提供する場合があるとされています。まず試したいだけであれば、一般公開されているプラグインから入るのが早い順序です。
15.これで置き換わらないもの
静的な検査(SAST)と動的な検査(DAST)は別
Codex Securityが担うのは、コードを読んで判断する静的な検査(SAST: Static Application Security Testing)です。これに対して、動いているアプリケーションに実際の通信を投げて外側から確かめる検査を動的な検査(DAST: Dynamic Application Security Testing)と呼びます。さらに、攻撃者の立場で目的(たとえば顧客データに到達できるか)を決め、経路をつなげて到達できるかを確かめるものがペネトレーションテスト(侵入テスト)です。
SAST(コードを読む)
- 文脈依存の欠陥
- CIだけで完結
脆弱性を見つける
DAST(外から叩く)
- 配信・設定の欠陥
- 実際の到達性
日本語では動的な検査までを「脆弱性診断」と呼ぶことが多く、弱点を広く洗い出すのが診断、決めた目的に到達できるかを確かめるのがペネトレーションテストという重心の違いがあります。
分担がはっきりするのはスキャンの対象です。Codex Securityが読むのは選んだリポジトリのコードで、対象外だった範囲はcoverage.jsonに記録されます。逆に言えば、リポジトリの外にあるものと、複数のサービスをつないだ状態は、動かしてみないと分かりません。次のようなものが該当します。
- マイクロサービス間の実際の到達性:認証をどのサービスが担保しているか、内部向けのはずのエンドポイントが外から直接叩けないか。1つのリポジトリのコードだけでは決まりません
- サーバー・配信側の設定:リバースプロキシやWAFの素通し、CORSやCSPなどのヘッダ、TLSの構成。多くはコードではなく設定として存在します
- 環境ごとの実際の値と権限:環境変数やシークレットに入っている値、クラウド側の権限の広さ。リポジトリにあるのは変数名までです
- 本番だけで出る差:本番と開発で違う設定、実データ、キャッシュやセッションの絡む挙動
SARIFで書き出せるのは、既存の管理の流れに結果を載せるためであって、他の検査を外すためではありません。セキュリティポリシーにも、検出の見落としや誤検知は実際の境界を越えない限りこの製品の不具合としては扱わないと書かれているので、見落としが起こる前提で他の手段と組み合わせます。
DAST・ペネトレーションテストをエージェントに任せる方法
DASTやペネトレーションテストは、何をどこまで見るのかが決まっていないと進みません。手順の枠組みとしてはOWASPのWeb Security Testing Guide(安定版は2020年12月公開の4.2)が、情報収集から各種の試験までを識別子付きで並べています。自動化と人手のどちらで進めるにしても、ここのどの項目を見たのかを残す形にすると抜けが分かります。
ZAPの公式サイトは、ZAPを世界で最も広く使われている無料・オープンソースのWebアプリのスキャナーだとし、セキュリティ自動化のための選択肢を備えていると説明しています。手元のエージェントから叩く形にすれば、スキャンの起動と結果の読み取りまでは任せられます。
NodeZeroの公式サイトによると、こちらは外部・内部のペネトレーションテストを自律的に実行する製品で、内部のテストは無料のDockerホストまたは仮想アプライアンスから、外部のテストは同社のクラウドから走らせる形になっています。エージェントの常駐は不要とされ、安全な実行を前提にした既定値と、都度使い切りの構成が説明されています。
外から試す検査は、対象のシステムに実際の通信を送ります。自社のシステムであっても、対象・時間帯・想定される影響を関係者と合意し、共用のインフラや外部サービスを対象に含めないことを確認してから実施してください。SaaSやクラウドを使っている場合は、提供元が示すテストの条件も先に確認します。
- 権限チェックの抜けのような、文脈を読まないと分からない欠陥を拾える
- 候補を検証してから提示するため、レビュー側に渡る誤検知が減る
- 差分だけのスキャンとコミット前フックで、指摘が出る位置を前へ動かせる
- 検出・修正案・履歴の比較が同じ仕組みに乗る
- 見落としは起こる。セキュリティポリシーでも扱いを保証していない
- 動いているアプリを外から試す検査は別に用意する
- 費用の上限は見積もりで、厳密な支出の上限ではない
- パッチは提案なので、適用前の確認と責任の所在を決めておく
16.よくある質問(FAQ)
Codex Securityは誰でも使えますか?
利用方法によって異なります。公式ドキュメントによると、CodexやChatGPTのデスクトップアプリから使うプラグインは一般公開されています。CLIとTypeScript SDKはパッケージ自体が公開されていますが、スキャンの実行には別途「Codex Securityへのアクセス」が必要で、取得の具体的な条件は明記されていません。GitHubのリポジトリを接続するクラウド側はリサーチプレビューです。コードはApache-2.0で公開されています。
スキャンの費用はどのくらいかかりますか?
使ったモデルとトークン量で決まります。パッケージのREADMEによると、各スキャンはモデル・トークン数・推定費用をJSON結果と履歴に記録し、推定には標準のAPIトークン価格が使われます(手数料や追加料金は含みません)。--max-cost USDで費用が上限を超えた時点で停止できますが、公式のCLIのFAQは、これが見積もりであって厳密な支出の上限ではないと明記しています。送信済みの要求は上限を超えて完了しうる点にも注意してください。
スキャンしたコードは学習に使われますか?
APIキーで使う場合、OpenAIのAPIのデータ取り扱いのガイドは、明示的に共有を選ばない限りAPIに送られたデータをモデルの学習や改善には使わないと説明しており、不正利用の監視ログは原則として最長30日保持されるとしています。ChatGPTのサインインで使う場合は利用中のプランのデータ設定に従うため、社内で使うならワークスペースの管理者と条件を確認してください。いずれの経路でも、判定はOpenAIのモデルが行うため、対象のコードはモデルへの要求として送信されます。
既存の脆弱性管理の仕組みに結果を取り込めますか?
SARIF・CSV・JSONで書き出せます。公式のCI統合ガイドでは、export --export-format sarifで書き出す手順が示されており、パッケージのREADMEによると、SARIFが生成される場合の出力先は<scan-dir>/exports/results.sarifです。取り込む前にcoverage.jsonでレビューの及んだ範囲を確認してください。カバレッジが不完全なスキャンは終了コード2になり、方針を満たした状態とは区別されます。
既存の静的解析や脆弱性診断は不要になりますか?
置き換えではなく併用が前提です。Codex Securityはコードを読んで判断するツールで、動いているアプリケーションに通信を投げて確かめる検査とは対象が異なります。外から試す側は、OWASPのWeb Security Testing Guideのような枠組みで対象を決めたうえで、ZAPのようなスキャナを自動化に組み込むか、NodeZeroのような自律型のペネトレーションテストを使う形になります。セキュリティポリシーでも、検出の見落としや誤検知は実際の境界を越えない限り製品の不具合としては扱わないとされています。
スキャン結果はどこに保存されますか?
--output-dirを指定しない場合、公式のCLIリファレンスによると結果は$CODEX_HOME/state/plugins/codex-security/scans/<repository>に残り、CODEX_HOMEの既定は~/.codexです。CODEX_SECURITY_STATE_DIRで保存先を変えられます。出力ディレクトリはスキャン対象とGitの作業ツリーの外に置く必要があり、macOSとLinuxでは本人だけのアクセス権(chmod 700)が求められます。結果にはソースの抜粋や再現手順が含まれうるため、参照できる範囲を絞って扱ってください。
17.まとめ
Codex Securityは、脆弱性の検出だけでなく、隔離した環境での検証と修正案の生成までを1つの流れに収めたセキュリティエージェントです。2026年7月にCLIとTypeScript SDKがApache-2.0で公開され、開発の流れに載せるための手段が揃いました。差分だけのスキャン、SARIFでの書き出し、コミット前フック、複数リポジトリのまとめてのスキャンが、いずれも同じCLIから使えます。
導入を検討するときに確認しておく点は3つです。
- 公開されたのはCLIとSDKで、判定はOpenAIのモデルが行います。スキャンの実行には別途「Codex Securityへのアクセス」が必要で、対話的に試すだけならまずプラグインから試す順序になります
- スキャンは対話的な承認を求めず、利用者のOS権限で動きます。対象は信頼できるリポジトリに絞り、渡す環境変数も絞ります
- 費用は使ったトークンで決まり、指定できる上限は見積もりによる停止です。対象の絞り込みと併用します
そのうえで、カバレッジの状態を必ず見る運用にしておくと、「検出0件」を安全の証明と読み替える事故を避けられます。見落としは起こる前提で、既存の検査や人のレビューと役割を分けて置くのが、いちばん無理のない入れ方です。
AIにコードを書かせる量が増えるほど、セキュリティの重要性も上がっていきます。弊社では、AIをフル活用したWeb制作・運用の中で、こうした開発と運用の土台づくりのご相談も承っています。
AI活用の開発・運用体制づくりをご相談ください
弊社では AI フル活用の運用保守・記事更新・計測改善までを提供しています。レビュー体制の整備からCIの改善まで、無料相談からお気軽にお問い合わせください。
